
PR:この記事にはアフィリエイトリンクが含まれます。
社内文書を生成AIに渡しても、質問に合う規程や手順書へたどり着けないことがあります。回答を支えるには、検索の仕組みも欠かせません。だからこそ、文書検索と生成AIを組み合わせるRAGが注目されています。
PythonでRAGを実装するときは、モデル呼び出しのほかに、文書の分割、埋め込み、検索、評価も考えます。社内文書検索を試す人からベクトルデータベースを深く学びたい人まで、役立つ本を紹介します。
本の早見表
| 書籍 | 主なテーマ | 参考価格(税込) |
|---|---|---|
 世界一やさしいRAG構築入門 | Azureで社内規程検索RAGを構築 | 3,300円 |
 LangChainとLangGraphによるRAG・AIエージェント[実践]入門 | LangChainのRAG、検索改善、評価 | 3,960円 |
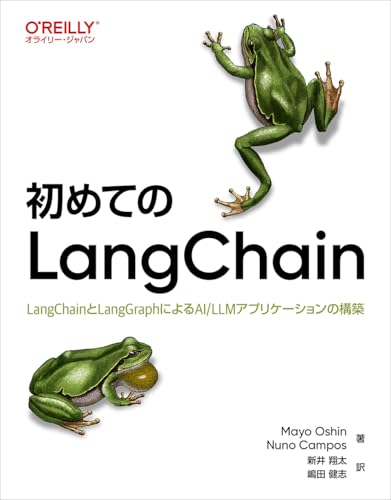 初めてのLangChain | RAGの構築から運用まで | 4,620円 |
 ベクトルデータベース | Pythonと複数DBで検索基盤を実装 | 4,840円 |
表の価格は税込の参考価格です。実売価格は時期や販売店によって変わるので、購入時には販売先の表示を確認してください。4冊の焦点は、Azureでの構築、LangChainによる開発、ベクトル検索の基礎です。
文書の取り込みからチャットUIまで作る本は、社内検索の全体像を追いやすい構成です。検索精度の評価やデプロイも学びたい人には、その工程まで扱う本がおすすめです。
RAGの基本
RAGは、質問に関係する文書を検索し、その内容を生成AIへ渡して回答を作る仕組みです。質問のたびに必要な箇所を検索して回答に使うため、社内規程をモデルに丸ごと覚えさせる必要はありません。これがRAGの特徴ですね。
まず文書を小さく分け、埋め込みモデルで各部分を数値ベクトルに変換します。質問も同じ方式で表し、意味の近い文書片を探して回答材料にします。
回答に出典名や該当箇所を添えると、利用者は元文書を確認しやすくなります。検索結果がずれていれば回答にも誤りが混じるため、文章の自然さと検索の質をそれぞれ点検しましょう。
社内文書検索
部署によって同じ用語の意味が異なることもあれば、改訂前のファイルが残ることもあります。文書名や部署、更新日、公開範囲なども属性として一緒に持たせると、回答の根拠を追いやすくなりますよ。
PDFやWordの本文を取り込む際は、見出しや表の構造も確認します。同じ文字数で機械的に切ると、条件と例外が別々になり、検索結果の意味が薄れることも。分割方法にも目を配りたいですね。
アクセス権の扱いも設計に含めます。検索結果を生成AIへ渡す前に質問者が閲覧できる文書だけに絞り、更新や削除をインデックスへ反映する運用を整えます。
Python実装
PythonでRAGを組む流れは、文書の読み込み、分割、埋め込み、保存、検索、生成です。工程ごとに処理を分けておけば、検索方式や生成モデルを変えたときも、修正箇所を見つけやすくなります。
たとえば社内規程の見出しと本文を一緒に保存し、検索上位の文書片をプロンプトへ加えます。回答に参照元を添え、該当文書が見つからないときは追加確認を促すと、無理な断定を避けられます。
試作が動くと安心したくなりますが、文書の更新や重複登録、検索結果が空になる場合も確認対象です。小さなテスト用文書と質問を用意すれば、変更後に検索品質が落ちていないか確かめられます。
ベクトルDB
ベクトルデータベースは、文章を数値化した埋め込みを保存し、意味の近い項目を探すための仕組みです。キーワード検索は単語の一致に強く、ベクトル検索は異なる表現の質問から候補を見つけやすい特徴があります。
実装時には検索速度やデータ更新、既存システムとの接続が関わります。少量の文書で試す構成と、利用者やデータが増えた後の構成は同じでなくても構いません。要件と運用負荷を並べて考えるのが現実的です。
キーワード検索とベクトル検索を組み合わせる方法が、ハイブリッド検索です。たとえば社内規程番号のような固有文字列はキーワード検索で拾い、意味が似た質問はベクトル検索で探せます。
精度と運用
回答が自然かどうかだけではRAGの品質を測れません。必要な文書が検索されたか、根拠が検索箇所にあるか、生成文が根拠から外れていないかを個別に確認します。
代表的な質問と正解の文書や回答の要点を記録しておけば、変更前後を比べやすくなります。検索対象や分割方法を変えた結果、一部の質問で検索品質が落ちることもあります。
運用開始後は、利用者の質問や評価を改善に活かします。検索できなかった質問を見直し、文書の整理、チャンク分割、検索方法、プロンプトのどこに原因があるか探ると、次の修正につながります。
Azure構築入門
『世界一やさしいRAG構築入門』は、Azure OpenAI ServiceとAzure AI Searchを使い、社内規程検索のRAGを組む本です。PythonでインデクサーやRetriever、Generatorを実装し、StreamlitのチャットUIまで作ります。
構築後は、人手やLLMによる評価を行い、Prompt Flowを使った改善にも取り組みます。セマンティックチャンキング、HyDE、ハイブリッド検索も扱うため、回答が期待と違うときに検索や分割を見直す視点が得られます。
Azureを使う社内プロジェクトの担当者や、RAGを初めて学ぶ人に適した内容です。2025年刊、336ページで、参考価格は税込3,300円。Azure上で規程検索を動かす具体像をつかみたい人に役立ちます。
LangChain実践
『LangChainとLangGraphによるRAG・AIエージェント[実践]入門』は、OpenAI APIとLangChainを使う開発者向けです。Document loader、Embedding model、Vector storeといった部品をつなぎ、RAGを構築する流れを実践的に学べます。
検索改善では、HyDE、複数クエリ、RAG-Fusion、リランキング、ハイブリッド検索を扱います。候補を増やす手法や、回答に使う文書の順序を整える方法も学べるため、検索改善の手段を広げたい人に合います。
LangSmithとRagasによるオフライン評価に加え、合成テストデータや利用者フィードバックの収集も扱います。RAGからLangGraphのエージェント開発へ進みたい開発者にも役立つでしょう。参考価格は税込3,960円です。
LangChain入門
『初めてのLangChain』は、PythonとJavaScriptのサンプルで、インデックス作成から文書分割、埋め込み、PGVectorへの保存、検索まで扱います。文書の変更追跡も対象で、更新の多い社内ナレッジを考える際の参考になります。
テスト、継続的インテグレーションとデリバリー、デプロイ、監視、評価、継続的な改善まで扱います。RAGを試す段階から、アプリとして保守するところまで知りたい開発者に実用的です。
2025年発行、296ページで、参考価格は税込4,620円。LangChainの基本から運用へ進む見通しを持ちたい人や、Pythonに加えてJavaScriptの例も見たい人に合います。
ベクトルDB実践
『ベクトルデータベース』は、RAGフレームワーク全体よりも、埋め込みやベクトル検索、インデックス設計を掘り下げる本です。PythonでFAISS、SQLite VSS、PostgreSQLのpgvectorなどを扱い、検索基盤を学びます。
HNSWや量子化、検索性能の調整も取り上げています。データ量や応答速度を踏まえてベクトル検索を設計したい人に役立つ内容です。SQLite VSSとOllamaによるRAG構築もあり、仕組みを手元で試せます。
2026年刊、304ページで、参考価格は税込4,840円です。既存のPythonアプリにベクトル検索を組み込みたいエンジニアや、データベース選定の技術的根拠を考えたい人に適しています。
結論
Azure上で社内規程検索を動かすなら、『世界一やさしいRAG構築入門』がおすすめです。Pythonで実装し、評価と改善まで進む流れを追えます。
LangChainで検索改善や評価を試す人には『LangChainとLangGraphによるRAG・AIエージェント[実践]入門』、テストやデプロイまで学ぶ人には『初めてのLangChain』が有力です。ベクトル検索の方式や性能を深く掘り下げるなら、『ベクトルデータベース』が合うでしょう。
作りたい社内検索の環境と深めたい工程を軸にすると、候補を絞れます。生成AIの回答品質を支える検索基盤まで実装する人は、まずRAG全体の流れを扱う本から始め、必要に応じてLangChainやベクトルデータベースの専門書へ進むと、学習内容を現場の課題につなげやすくなります。

Amazon の PC をスコア化してみた

Amazonにある8〜14インチの小型WindowsタブレットやノートPCを、スペック別にスコア化して比較・ランキング。
